Mire képes ma a mesterséges intelligencia valójában?
A legtöbb cég nem azért bukik el az MI-vel, mert rossz eszközt választ.
Hanem mert rossz feladatra választja.
A mesterséges intelligencia alkalmazások értéke ugyanis nem a modell nevén múlik, hanem azon, hogy milyen problémát oldanak meg, és mennyire illeszkednek a meglévő működésbe.
Előbb tisztázzunk három fogalmat, mert a cikk többi része ezekre épül.
A gépi tanulás olyan algoritmusok gyűjtőneve, amelyek adatokból tanulnak mintázatokat, és ezek alapján előrejeleznek vagy osztályoznak.
A nagy nyelvi modell (LLM, például a GPT vagy a Claude) hatalmas szövegmennyiségen tanított rendszer, amely természetes nyelvfeldolgozással érti és állítja elő a szöveget.
A generatív mesterséges intelligencia pedig a tágabb kategória: minden olyan modell, amely új tartalmat hoz létre, legyen az szöveg, kép, kód vagy hang.
Magyarországon még bőven van hova fejlődni.
Az NMHH friss hazai felmérése is azt mutatja, hogy a vállalkozások jelentős része még csak ismerkedik az MI-vel, rendszeres, folyamatba épített használatról pedig kevesen számolnak be.
A Eurostat 2024-es adatai szerint a legalább 10 főt foglalkoztató magyar vállalkozásoknak mindössze 7,4%-a használt valamilyen MI-technológiát, miközben az uniós átlag 13,5% volt.
Ez a cikk ezért nem eszközlistát ad. Helyette egy feladatalapú keretrendszert mutat be: melyik MI-típus milyen munkára való, hogyan kapcsolható a meglévő rendszereidhez, és hogyan mérheted, hogy tényleg hoz-e eredményt.
Miért nem működnek az elszigetelt kísérletek? Mert egy marketinges saját ChatGPT-fiókja vagy egy gyorsan összerakott demó chatbot nem fér hozzá a cég adataihoz, senki nem felel érte, és senki nem méri.
Pár hét után elhal.
Az MI akkor teremt tartós értéket, ha a CRM-be, a jegykezelőbe vagy a webshopba épül, ott, ahol a munka amúgy is zajlik.
MI-típusok feladatalapú térképe
Meglepő, de a legtöbb „MI-projektnek” nevezett fejlesztésnek egyáltalán nincs szüksége nagy nyelvi modellre.
Sokszor egy jól megírt szabályrendszer olcsóbb, gyorsabb és megbízhatóbb.
A kérdés tehát mindig az, hogy mi a feladat, és nem az, hogy melyik a legdivatosabb technológia.
Az alábbi táblázat öt fő kategóriát foglal össze. Mindegyiknél ott van az is, mikor nem érdemes használni, mert ez a rész spórolja meg a legtöbb pénzt.
| MI-típus | Tipikus feladat | Konkrét példa | Mikor NEM ajánlott? |
|---|---|---|---|
| AI chatbot / virtuális asszisztens | Párbeszédes ügyfélkiszolgálás, belső tudásbázis lekérdezése, időpontfoglalás | Webshop-asszisztens, amely a szállítási és visszaküldési kérdések 60-70%-át emberi beavatkozás nélkül megválaszolja | Ha nincs rendezett tudásbázis, vagy ha a kérdések többsége egyedi, érzelmileg terhelt panasz |
| Generatív MI (szöveg, kép, kód) | Tartalomkészítés, összefoglalás, fordítás, kódgenerálás, termékleírások | 200 termékleírás első verziójának elkészítése egy délután alatt, amit szerkesztő néz át | Ha a kimenetet senki nem ellenőrzi, vagy ha tényszerű pontosság kell forrás nélkül (jogi szöveg, gyógyszeradagolás) |
| Prediktív analitika és ajánlórendszer | Kereslet-előrejelzés, lemorzsolódás előrejelzése, személyre szabott ajánlatok | „Ezt is megvették mellé” blokk egy webshopban, vagy készletszint-előrejelzés szezonális termékekre | Ha kevesebb mint néhány ezer múltbeli tranzakció áll rendelkezésre, vagy ha az adatok szétszórtak és hiányosak |
| Gépi látás és dokumentumfeldolgozás | Számlák, szerződések, űrlapok adatkinyerése, képek minőségellenőrzése | Beérkező szállítói számlák automatikus beolvasása és rögzítése a könyvelőprogramba | Ha havonta csak néhány tucat dokumentum érkezik, vagy ha a formátumok annyira eltérők, hogy a kézi ellenőrzés úgyis 100%-os marad |
| Szabályalapú automatizálás | Ismétlődő, egyértelmű „ha X, akkor Y” lépések | Új rendelésnél automatikus visszaigazoló e-mail, számlakiállítás és Slack-értesítés | Ha a döntéshez szövegértelmezés, mérlegelés vagy szokatlan esetek kezelése kell |
Az utolsó sor szándékosan szerepel itt, pedig szigorúan véve nem MI. A gyakorlatban viszont a legtöbb sikeres intelligens automatizálás éppen szabályalapú lépések és MI-komponensek keverékéből áll.
Chatbot, generatív MI és automatizálás: mi a különbség?
Vegyünk egy hétköznapi helyzetet: beérkezik egy ügyfél-e-mail, amelyben valaki azt kérdezi, hol tart a rendelése, és közben panaszkodik, hogy a múltkori csomag sérülten érkezett. Három különböző technológia háromféleképpen nyúlhat hozzá.
A szabályalapú automatizálás kulcsszavakat keres.
Ha a levélben szerepel a „rendelés” szó, kiküld egy sablonválaszt a követési linkkel.
Gyors és olcsó, de a sérült csomagról szóló részt teljesen figyelmen kívül hagyja.
Az AI chatbot párbeszédet folytat.
Rákérdez a rendelésszámra, lekérdezi a státuszt, és felajánlja a reklamációs űrlapot.
Jól működik, ha az ügyfél valós időben, élő csatornán kommunikál.
A generatív MI megérti a teljes levelet, felismeri benne a két külön témát, és személyre szabott választervezetet ír, amely mindkettőre reagál. A levelet aztán egy munkatárs egy kattintással jóváhagyja vagy módosítja.
És itt jön a lényeg.
Egy élő rendszer ritkán használ csak egyet ezek közül.
A jó megoldás így néz ki: a generatív modell kategorizálja a levelet, a szabályrendszer a kategória alapján továbbítja a megfelelő sorba, a rendelésstátuszt API-n kérdezi le, a választervezetet pedig ember hagyja jóvá.
Négy lépés, három technológia, egyetlen folyamat.
Hogyan épül be az MI egy appba vagy weboldalba?
Egy nagy nyelvi modell önmagában olyan, mint egy zseniális új kolléga, aki az első napon semmihez nem kap hozzáférést.
Okos, de nem ismeri az ügyfeleidet, az árlistádat és a belső szabályaidat.
Az integráció arról szól, hogy ezt a tudást biztonságosan, ellenőrzötten add át neki.
Adatok és adatminőség
Az MI pontosan annyira jó, amennyire az adatok, amikből dolgozik.
A strukturált adat egyértelmű mezőkbe rendezett információ (ügyfélnév, rendelésdátum, összeg), amit a gép félreértés nélkül tud olvasni. A PDF-ekben, e-mailekben és táblázatok megjegyzés-oszlopaiban szétszórt tudás ezzel szemben strukturálatlan, és előkészítés nélkül nehezen használható.
Ha a termékadatbázisban duplikált tételek, elavult árak vagy üres mezők vannak, a modell ezekből fog válaszolni.
Magabiztosan.
És tévesen.
Ezért az adatminőség és adatkormányzás nem mellékes IT-feladat.
Tisztázni kell, ki fér hozzá mihez: a chatbot láthatja a rendelésstátuszt, de nem láthatja más ügyfelek címét.
A vállalati tudásbázisra épülő megoldásoknál a RAG (Retrieval-Augmented Generation) technika a bevett minta, ahol a modell minden válasz előtt a saját, ellenőrzött dokumentumaidból keresi ki a releváns részeket.
Kapcsolódás a meglévő rendszerekhez
Az MI-komponens ritkán áll közvetlen kapcsolatban az összes céges rendszerrel. A tipikus architektúrában van egy middleware réteg középen, amely összefogja a forgalmat a CRM, az ERP, az ügyfélszolgálati rendszer és a webshop között.
A kommunikáció két fő módon zajlik. Az API-integráció révén az egyik rendszer lekérdez vagy elküld adatot a másiknak (például a chatbot lekéri a rendelés státuszát az ERP-ből). A webhook fordítva működik: egy esemény (új jegy, új rendelés) automatikusan jelez a middleware-nek, amely elindítja az MI-feldolgozást.
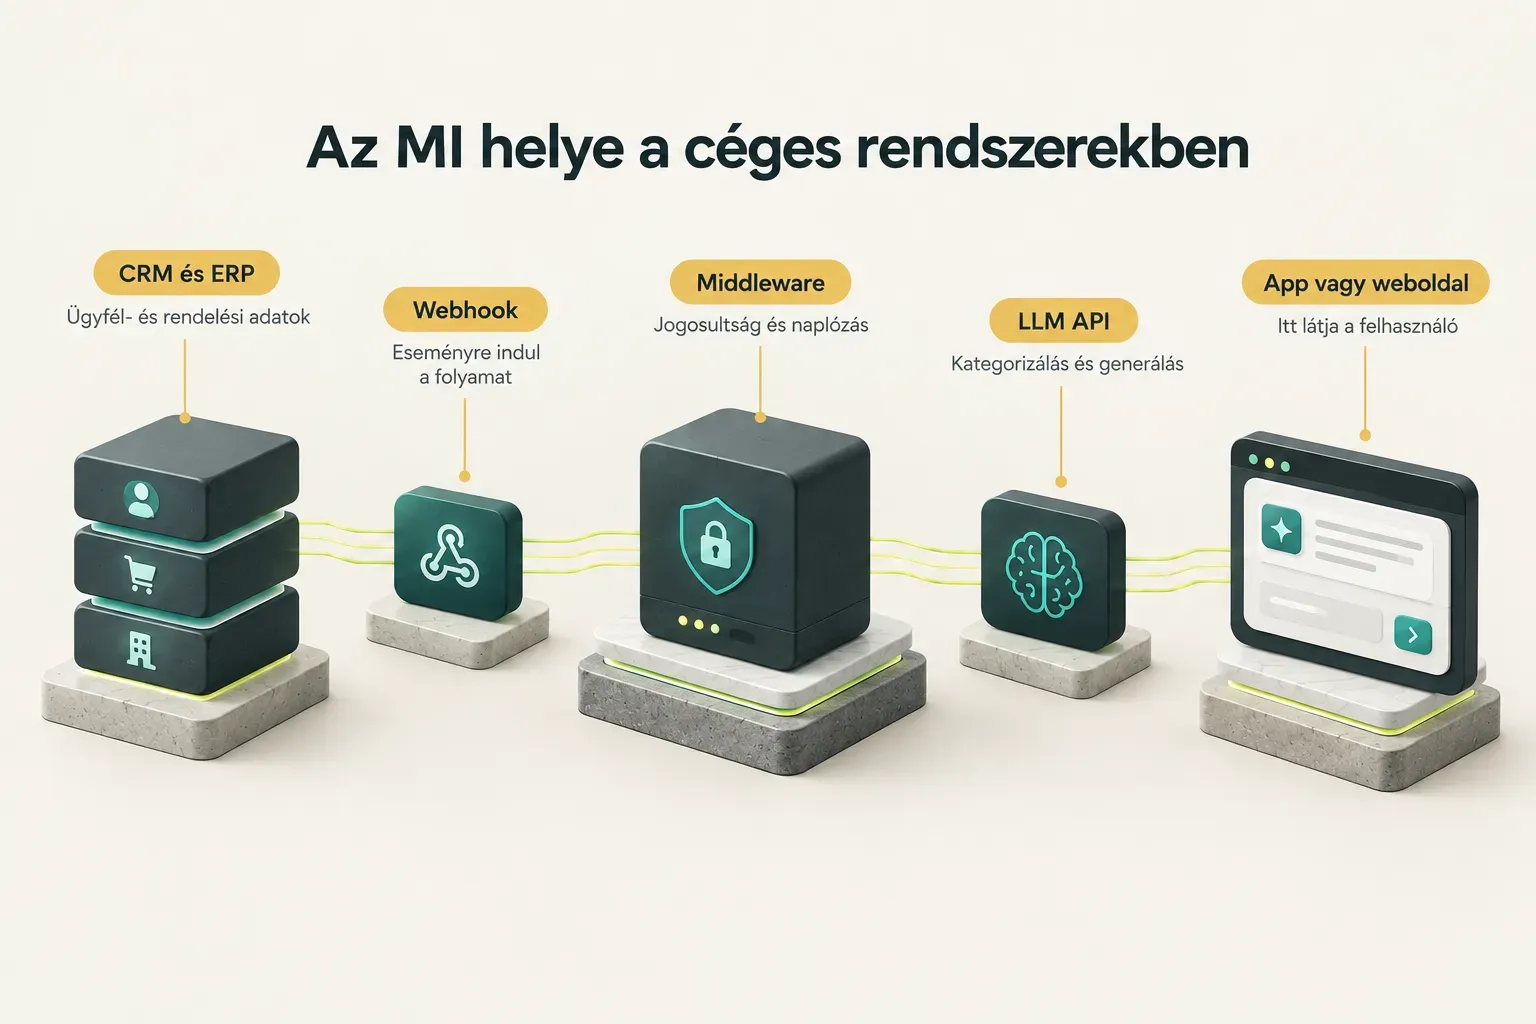
A middleware-ben dől el, milyen adat juthat el a modellhez, itt történik a naplózás, és itt lehet anonimizálni az érzékeny mezőket. Ha ezt a réteget kihagyod, minden rendszert minden rendszerrel külön kell összekötni, ami egy év múlva karbantarthatatlan pókhálót eredményez.
Kész eszköz, API vagy egyedi fejlesztés
Három út létezik, és egyik sem eleve jobb a másiknál.
A no-code chatbot-eszköz akkor elég, ha a feladat egy weboldalba ágyazott GYIK-asszisztens, a tudásanyag néhány tucat oldal, és nem kell valós idejű adatot lekérni más rendszerekből.
Napok alatt élesíthető, havi néhány tízezer forintból.
Az API-integráció akkor indokolt, ha a meglévő szoftveredbe akarod beépíteni az MI-t: a jegykezelő automatikusan kategorizáljon, vagy a CRM generáljon összefoglalót az ügyfél előzményeiből. Ehhez fejlesztő kell, de a felhasználói felület marad a régi.
Az egyedi web- vagy mobilalkalmazás akkor éri meg, ha maga az MI-funkció a termék része, egyedi üzleti logikával.
A CompletApp hazai projektjeinél, például a Frendex és az Apartmanom esetében, jól látszik a bevált minta.
Az OpenAI vagy a Claude API-ja nem közvetlenül az alkalmazásból, hanem egy Firebase vagy Supabase alapú backend és adatbázis szerveroldali függvényén keresztül hívódik, így az API-kulcs és a felhasználói adatok nem kerülnek ki a kliensre.
Az MI itt három szerepet tölthet be: asszisztensként válaszol a felhasználó kérdéseire, generálóként szöveget készít (például egy szálláshirdetés leírását), kategorizálóként pedig a beérkező tartalmat címkézi és sorolja be. A gondos prompttervezés és a backendben tárolt kontextus együtt adja azt, hogy a válasz a termék logikájához igazodjon, ne általános csevegés legyen.
A pilottól az éles üzemig
A legtöbb MI-projekt nem a technológián csúszik el, hanem azon, hogy senki nem írta le előre, mit tekint sikernek.
Ha nincs mérhető cél, a pilot végén csak benyomások maradnak.
„Elég jónak tűnik”… ez nem üzleti döntés alapja.
Az alábbi hat lépés egy 4-8 hetes, kontrollált bevezetés vázát adja, amely kkv-méretben is végigvihető.
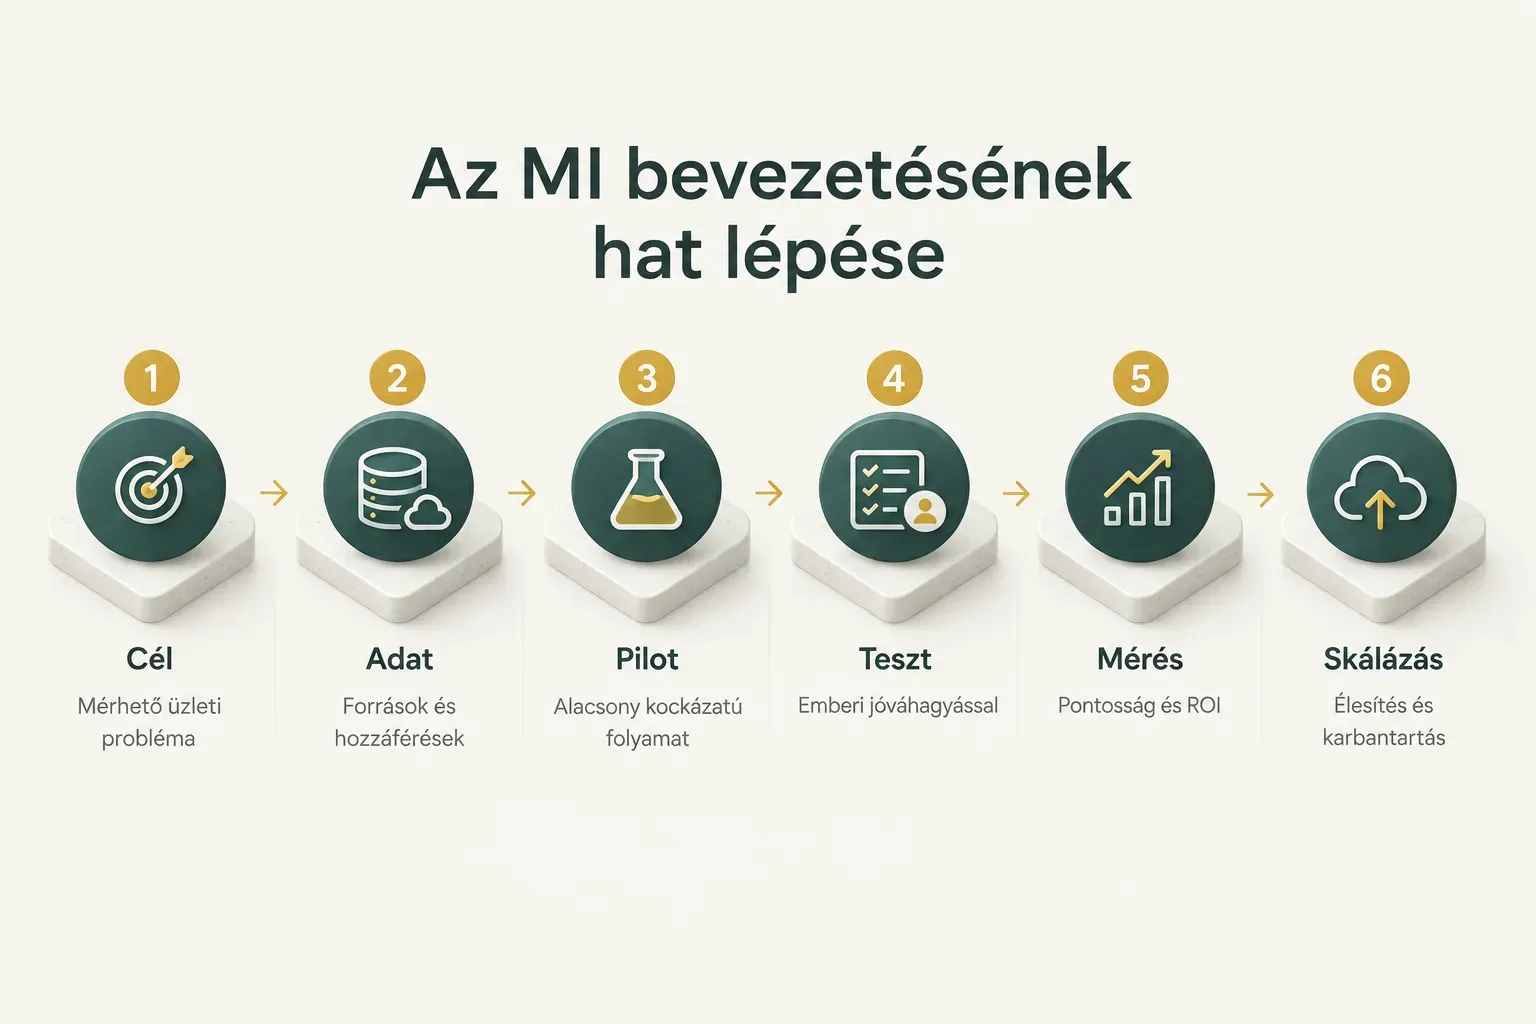
- Konkrét üzleti probléma és mérhető cél meghatározása. Ne azt írd le, hogy „használjunk MI-t az ügyfélszolgálaton”, hanem azt, hogy „az első válaszidőt 8 óráról 4 órára, vagyis 50%-kal csökkentjük három hónap alatt”. Egyetlen, számszerű cél többet ér öt homályos ambíciónál.
- Adatfelmérés és a hozzáférések tisztázása. Térképezd fel, hol van a szükséges tudás (tudásbázis, korábbi jegyek, termékadatbázis), milyen állapotban van, és ki adhat hozzá hozzáférést. Ebben a fázisban derül ki a leggyakrabban, hogy az adatok tisztítása több munka, mint maga az MI-integráció.
- Alacsony kockázatú pilot folyamat kiválasztása. Olyan feladattal kezdj, ahol egy hibás kimenet nem okoz komoly kárt, például egy belső GYIK-chatbottal vagy beérkező számlák dokumentumfeldolgozásával. A kockázatos, ügyfél felé irányuló döntéseket hagyd a második körre.
- Tesztelés emberi jóváhagyással, szűk felhasználói körön. A human-in-the-loop modellben az MI javasol, az ember dönt: minden választervezetet vagy kinyert adatot egy munkatárs hagy jóvá az első hetekben. Egy 3-5 fős tesztcsapat elég, és minden javítást rögzíts, mert ezekből lesz a következő promptverzió alapja.
- Mérőszámok rögzítése. Kövesd a válaszpontosságot (hány kimenetet fogadtak el módosítás nélkül), az átfutási időt, az automatizálási arányt, az ügyfél-elégedettséget, a hibaarányt és az AI-megoldás megtérülését (ROI). A ROI-hoz számold össze a megspórolt munkaórákat, és vesd össze az API-költséggel és a fejlesztési ráfordítással.
- Skálázás élesbe és folyamatos karbantartás. Ha a pilot elérte a célt, építsd be véglegesen a meglévő rendszerbe, és fokozatosan bővítsd a felhasználói kört. Az élesítés nem a projekt vége: a valós felhasználói viselkedés alapján havonta érdemes átnézni a hibás eseteket, frissíteni a tudásbázist és finomítani a promptokat.
Egy jó ökölszabály: ha a pilot végén a kimenetek legalább 80%-át módosítás nélkül elfogadják a munkatársak, és a cél mérőszám elmozdult, lehet skálázni. Ha nem, inkább a 2. lépéshez menj vissza, mert a gond szinte mindig az adatokban van, nem a modellben.
Kockázatok, adatvédelem és az EU AI Act
Mi történik azzal a szöveggel, amit egy munkatárs bemásol egy ingyenes MI-csevegőbe?
Sok cégvezető erre csak akkor gondol, amikor már egy teljes ügyféllista vagy egy ajánlat került ki a házból.
Pedig a kockázatkezelés nem fékezi a bevezetést, hanem lehetővé teszi.
Adatvédelem és üzleti titkok
Ügyfelek személyes adatait csak akkor szabad külső MI-szolgáltatásnak átadni, ha erre van GDPR szerinti jogalap, adatfeldolgozói szerződés, és a szolgáltató vállalja, hogy az adatokat nem használja modelltanításra. Az OpenAI, az Anthropic és a Google üzleti (API és enterprise) konstrukciói ezt alapértelmezésként vállalják, a fogyasztói, ingyenes felületeknél viszont a beállításokat külön ellenőrizni kell.
Gyakorlati szabály: neveket, e-mail-címeket, adószámokat és egészségügyi adatokat a middleware-ben érdemes anonimizálni, mielőtt a modellhez kerülnek. Üzleti titkot (árkalkulációt, forráskódot, folyamatban lévő tárgyalást) pedig csak céges, szerződéssel lefedett fiókon keresztül szabad feldolgoztatni.
Az EU AI Act kockázati szintjei
Az EU AI Act 2024 augusztusában lépett hatályba, és kockázatalapú megközelítéssel négy kategóriába sorolja az MI-rendszereket. Az elfogadhatatlan kockázatú gyakorlatok (például a társadalmi pontozás vagy a munkahelyi érzelemfelismerés) 2025 februárja óta tilosak.
A magas kockázatú kategóriába tartozik többek között a toborzásban, hitelbírálatban vagy oktatási értékelésben használt MI, amelyre szigorú dokumentációs és felügyeleti kötelezettségek vonatkoznak. Ezek fő része 2026 augusztusától lenne alkalmazandó, bár az Európai Bizottság 2025 végén javasolta egyes határidők kitolását.
A korlátozott kockázatú rendszereknél (chatbotok, generált tartalom) átláthatósági kötelezettség van: a felhasználónak tudnia kell, hogy géppel beszél.
A minimális kockázatú alkalmazások, mint a spamszűrő vagy egy belső szövegösszefoglaló, gyakorlatilag szabadon használhatók.
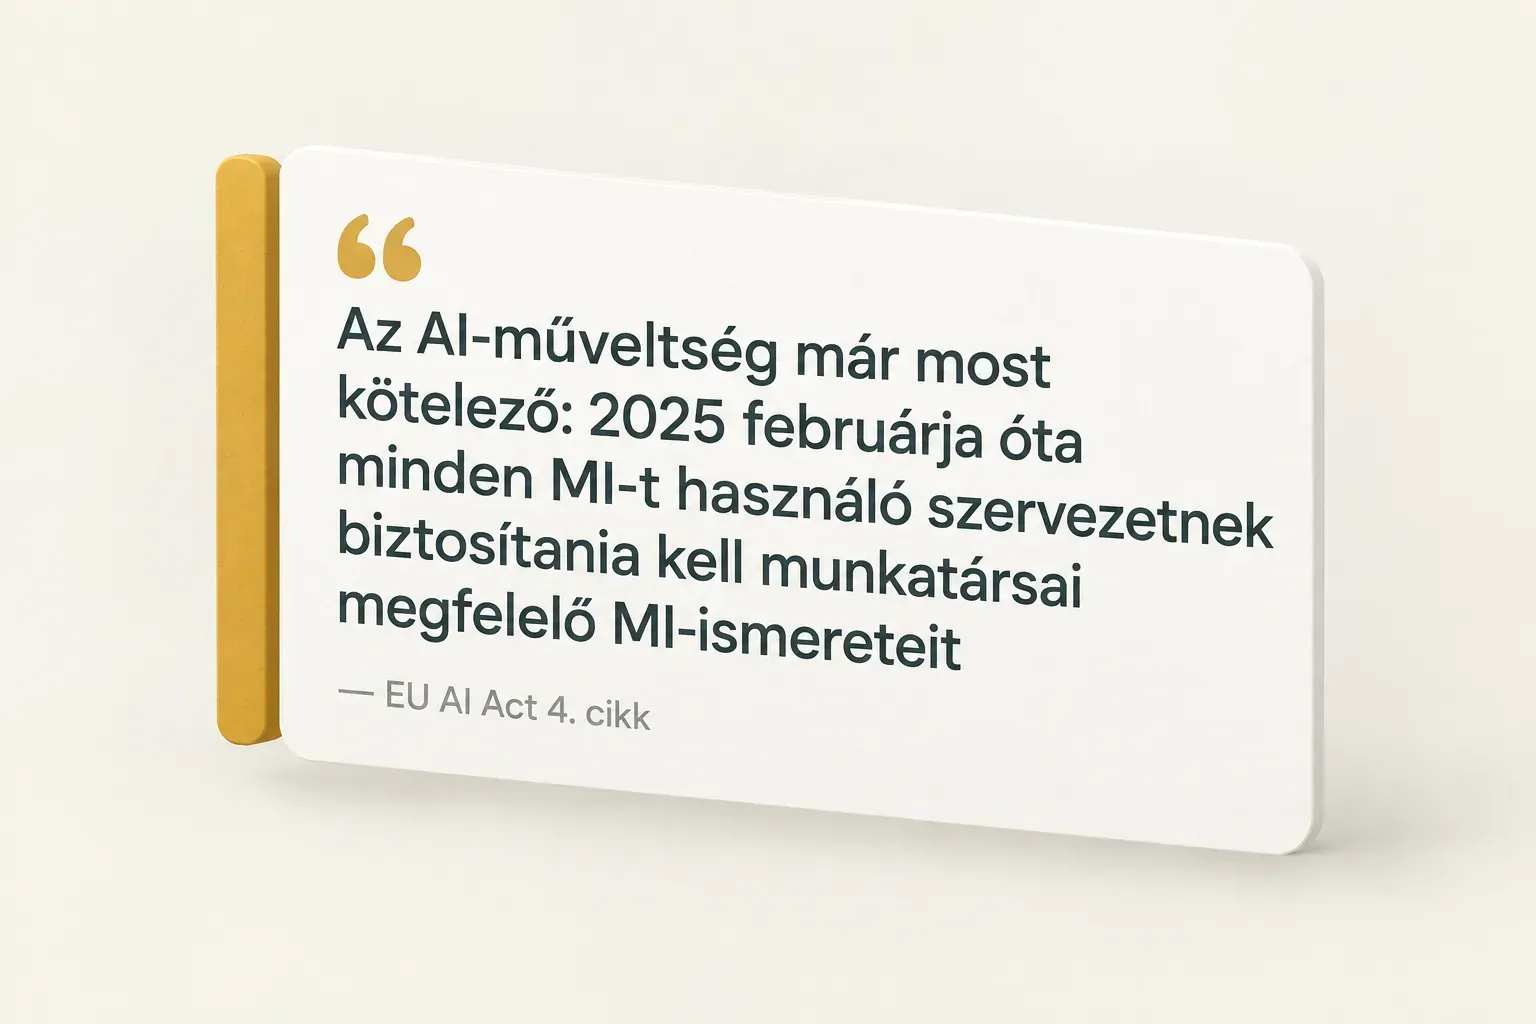
Egy átlagos magyar kkv számára ez a gyakorlatban így fordítható le: a webes chatbot korlátozott kockázatú, tehát jelezni kell, hogy MI válaszol. Az AI-műveltség biztosítása viszont mindenkire vonatkozik, vagyis a munkatársaknak érteniük kell, mire képes és mire nem az általuk használt eszköz.
Hallucinációk és emberi ellenőrzés
Az MI-hallucináció az, amikor a modell magabiztosan állít valótlant. Ennek oka, hogy a nagy nyelvi modell nem adatbázisból keres, hanem a legvalószínűbb következő szót jósolja meg, így ha nincs megbízható forrása, hihetően hangzó, de kitalált választ ad.
A kockázatot három gyakorlat csökkenti érdemben.
A RAG-alapú megoldásban a modell csak a megadott dokumentumokból válaszolhat, és minden válasz mellé forráshivatkozást ad.
A promptban explicit utasítás kell arra, hogy bizonytalan esetben mondja ki: „erre nincs információm”.
A harmadik pedig a mintavételes ellenőrzés: hetente legalább 20-30 véletlenszerű választ nézzen át egy ember.
Vannak helyzetek, ahol az automatikus MI-döntés egyszerűen nem opció.
Jogi tanácsadás, hitelbírálat, számlázási vita, orvosi tünetekkel kapcsolatos kérdés: ezekben az MI legfeljebb előkészíthet, a döntést emberi felülvizsgálatnak kell követnie.
Mindig.
Hol kezdd el holnap?
Nem kell stratégiai dokumentum ahhoz, hogy elindulj.
Egyetlen folyamat kell.
Válassz ki egy alacsony kockázatú, jól mérhető feladatot (a GYIK-kérdések megválaszolását, a számlák rögzítését vagy a beérkező e-mailek kategorizálását), írd le a kiinduló mérőszámot, és indíts rá egy 4-6 hetes pilotot.
A választás egyszerű döntési szabályra épülhet.
Ha az adataid rendezettek és a feladat ismétlődő, kezdj kész eszközzel, mert napok alatt kiderül, működik-e.
Ha viszont egyedi üzleti logika vagy mélyebb rendszerintegráció kell, például a CRM, a webshop és egy mobilapp összekötése, akkor az egyedi fejlesztés hosszú távon olcsóbb és rugalmasabb.
Nem az számít, melyik modell neve szerepel a hírekben. Az számít, hogy a megoldás beleillik-e a folyamatodba és a meglévő rendszeredbe, és hogy egy hónap múlva számokkal meg tudod-e mondani, mit hozott.
A sikeres mesterséges intelligencia alkalmazások ritkán látványosak.
Csendben dolgoznak a háttérben, és minden héten visszaadnak néhány órát.
Pontosan ez a cél.